Waarom een AI die “ik weet het niet” zegt meer waard is dan een die altijd antwoordt
Een taalmodel dat op elke vraag een vloeiend antwoord geeft, voelt slim. Tot u het antwoord natrekt en er blijkt niets onder te zitten. Het verschil tussen bruikbaar en onbruikbaar zit niet in het model, maar in of het mag zeggen dat het iets niet weet.
· ontwikkeling · 6 min · Mats Ponte
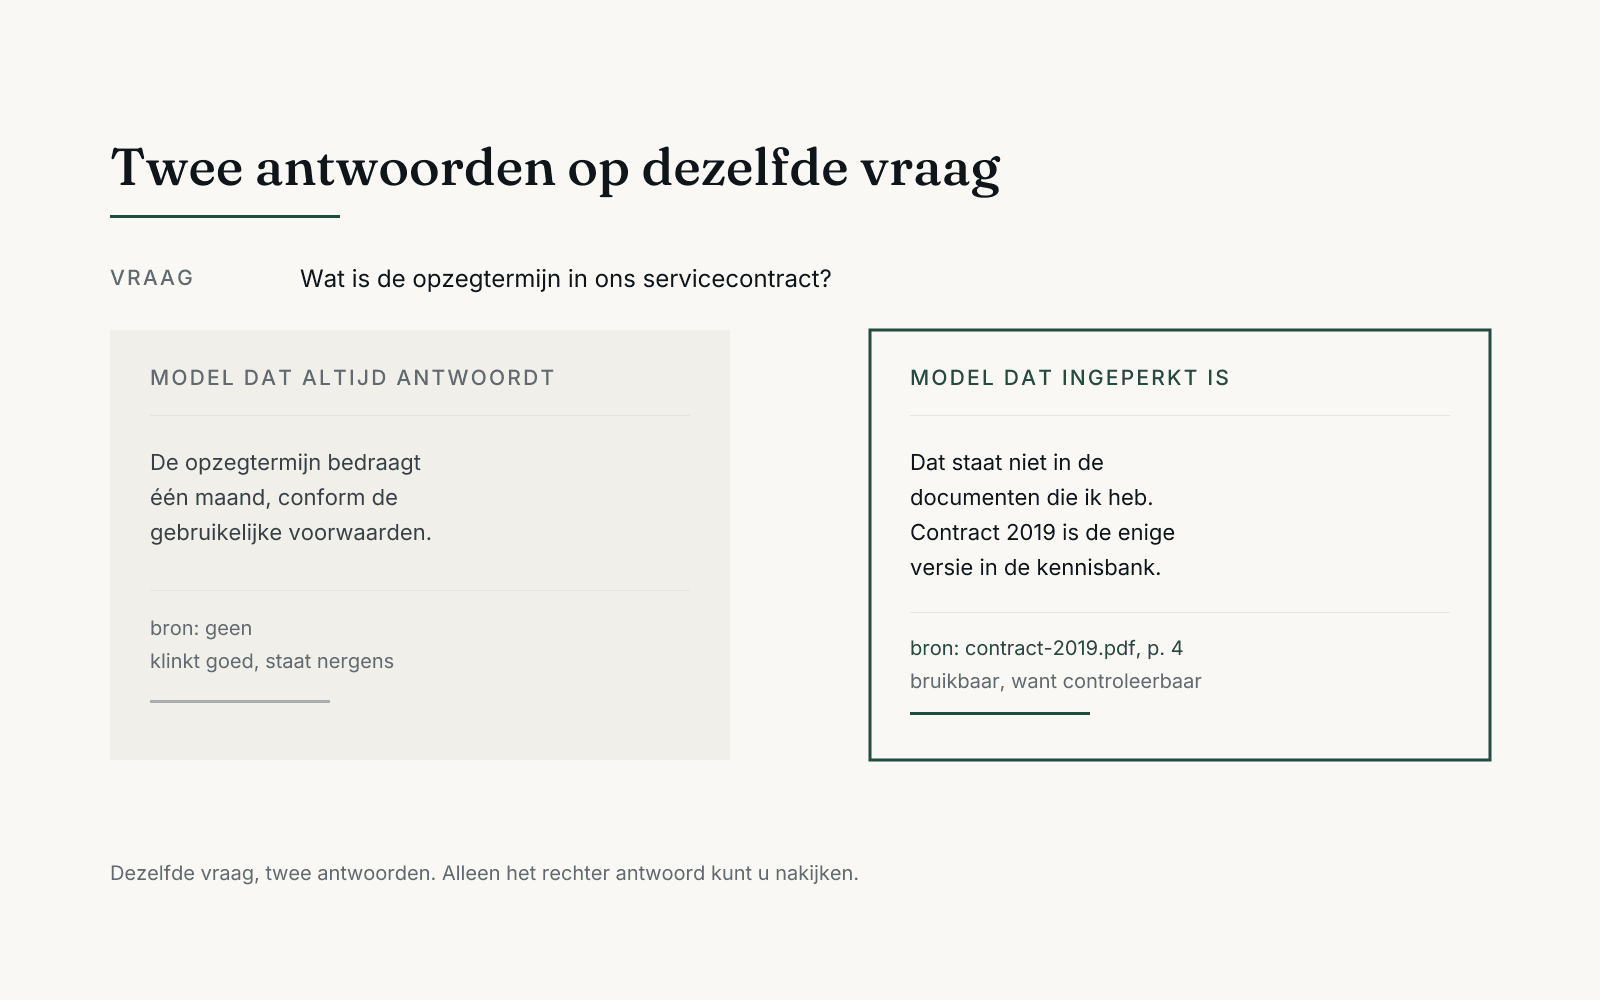
Ik laat bij een kennismaking graag hetzelfde kleine experiment zien. Ik stel een gewone chatbot een vraag over een document dat hij nooit heeft gezien, bijvoorbeeld de opzegtermijn in een servicecontract. Er komt een net geformuleerd antwoord terug, met een termijn erin en een verwijzing naar de gebruikelijke voorwaarden. Het klinkt volstrekt geloofwaardig. Het is ook volledig verzonnen.
Dat is geen storing en geen slecht model. Het is precies waarvoor het ding gebouwd is. En het is de reden dat ik bij bedrijfstoepassingen een ander soort systeem bouw dan de meeste mensen in gedachten hebben als ze aan AI denken.
Waarom een taalmodel nooit uit zichzelf stilvalt
Een taalmodel is getraind om steeds het volgende stukje tekst te voorspellen dat het best past bij wat eraan voorafging. Meer niet. Er zit geen aparte voorziening in die bijhoudt of het onderliggende feit ergens vandaan komt, want er is geen onderliggend feit: er is alleen een patroon dat op enorme hoeveelheden tekst is geleerd. Op de vraag naar een opzegtermijn is er een heel waarschijnlijke voortzetting, namelijk een termijn noemen, en die produceert het model.
Zwijgen is voor zo'n systeem juist een onwaarschijnlijke voortzetting. In vrijwel geen enkele tekst waarop het is getraind, staat halverwege een antwoord dat de schrijver het niet weet. Dat is de kern van het probleem, en het is ook meteen de verklaring waarom u er met een betere formulering van uw vraag niet uitkomt. Onderzoekers noemen het verschijnsel hallucinatie, en de literatuur erover is inmiddels omvangrijk; wat er in al die studies terugkomt is dat het niet met meer training verdwijnt, maar met een andere opzet eromheen.
Het verschil zit in de opzet, niet in het model
De oplossing die in de praktijk werkt, is het model niet uit zijn hoofd laten antwoorden. In plaats daarvan wordt bij elke vraag eerst gezocht in uw eigen documenten, worden de passages die er werkelijk toe doen meegestuurd, en krijgt het model de opdracht om uitsluitend op basis daarvan te antwoorden. Die aanpak heeft een naam, retrieval-augmented generation, en ze bestaat al sinds 2020. Ze is geen truc en geen instelling die u aanzet; het is een andere architectuur.
Twee dingen maken die opzet bruikbaar. Het eerste is dat het antwoord de bron meekrijgt: welk document, en waar daarin. Daarmee wordt elk antwoord controleerbaar, en dat verandert de aard van het gereedschap. U hoeft het niet te vertrouwen, u kunt het nakijken. Het tweede is dat het systeem expliciet mag en moet zeggen dat iets er niet in staat. Dat is een ontwerpkeuze die in de instructie en in de controle eromheen zit, en het is precies de keuze die de meeste kant-en-klare chatbots niet maken.
Wat dat eerlijke antwoord u oplevert
Het meest praktische voordeel merkt u pas na een paar weken: een systeem dat mag zeggen dat het iets niet weet, is te controleren. U kunt een set vragen samenstellen waarvan u het antwoord kent en meten hoe vaak het klopt. Bij een systeem dat altijd iets zegt, is die meting zinloos, want alles ziet er even overtuigend uit. U meet dan alleen nog hoe goed het formuleert.
Het tweede voordeel is dat elk niet-weet-antwoord een gratis inventarisatie is van uw eigen documentatie. Als medewerkers dertig keer per maand een vraag stellen waarop het systeem eerlijk moet zeggen dat het er niet in staat, dan hebt u geen AI-probleem maar een gat in uw kennisbank, en u weet nu precies waar. Dat inzicht krijgt u van een systeem dat altijd antwoordt nooit, want daar staat het gat vol met plausibele tekst.
En het derde is vertrouwen op de werkvloer, en dat is het voordeel waar het uiteindelijk om draait. Een medewerker die één keer een verzonnen antwoord aan een klant heeft doorgegeven, gebruikt dat hulpmiddel daarna niet meer. Dan hebt u wel betaald en niets gewonnen. Een systeem dat af en toe niets weet maar nooit iets verzint, wordt juist wel gebruikt.
Wat u ervoor inlevert
Ik wil hier niet doen alsof dit alleen maar winst is. Een ingeperkt systeem lijkt in de eerste week minder slim. Waar de gewone chatbot altijd iets terugzegt, komt hier regelmatig een leeg antwoord, en dat voelt als een tekortkoming terwijl het de bedoeling is. Daar moet u uw mensen op voorbereiden, anders is de conclusie na twee dagen dat het niet werkt.
Daarnaast verplaatst het werk zich. De kwaliteit van de antwoorden wordt bepaald door de kwaliteit en de ordening van uw documenten. Als er drie versies van hetzelfde protocol rondslingeren, moet iemand bepalen welke leidend is, en dat oordeel is van u en niet van mij. Wat ik wel kan doen, is zichtbaar maken waar de tegenstrijdigheden zitten. Dat is vaak het nuttigste bijproduct van zo'n project.
Hoe ik het toets voordat het in gebruik gaat
Voor de oplevering stel ik samen met u een vaste set vragen samen. Daarin zitten twee soorten. De eerste soort zijn vragen waarvan u het antwoord kent en waarvan het antwoord in de documenten staat: die moeten kloppen, inclusief de bron. De tweede soort zijn vragen waarvan we weten dat het antwoord er níet in staat. Daar is het goede antwoord dat het systeem dat zegt. Die tweede soort wordt in de meeste projecten vergeten, en dat is nou net de soort die u laat zien of er onder druk toch iets wordt verzonnen.
Die set blijft daarna bestaan. Als er documenten bijkomen of een model wordt vervangen, draait u hem opnieuw en ziet u meteen of de kwaliteit nog klopt. Zo houdt u zelf de hand aan de kraan, ook als ik allang klaar ben.
Bronnen
- Lewis e.a., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020) https://arxiv.org/abs/2005.11401
- Ji e.a., Survey of Hallucination in Natural Language Generation (2022) https://arxiv.org/abs/2202.03629
- NIST, AI Risk Management Framework (AI RMF 1.0), over meten en beheersen van betrouwbaarheid https://www.nist.gov/itl/ai-risk-management-framework
Beeld: Eigen werk, Aether AI · Geen licentie van derden nodig