AI op uw eigen server: wanneer dat kan, wat u inlevert en wat het oplevert
De vraag waar mijn gegevens blijven, is voor veel ondernemers de eerste en niet de laatste. Het goede nieuws is dat het antwoord een technische keuze is en geen belofte: een open model kan volledig binnen uw pand draaien. Het eerlijke nieuws is dat u daar ook iets voor inlevert.
· ontwikkeling · 7 min · Mats Ponte
Bij bedrijven die met patiëntgegevens, cliëntdossiers of contracten van klanten werken, komt de vraag vrijwel altijd voordat we het over de techniek hebben: waar blijft onze data. Dat is de goede volgorde, want het antwoord bepaalt de hele opzet en niet andersom. En het antwoord is geen kwestie van vertrouwen in mij of in een leverancier, het is een keuze die u kunt afdwingen.
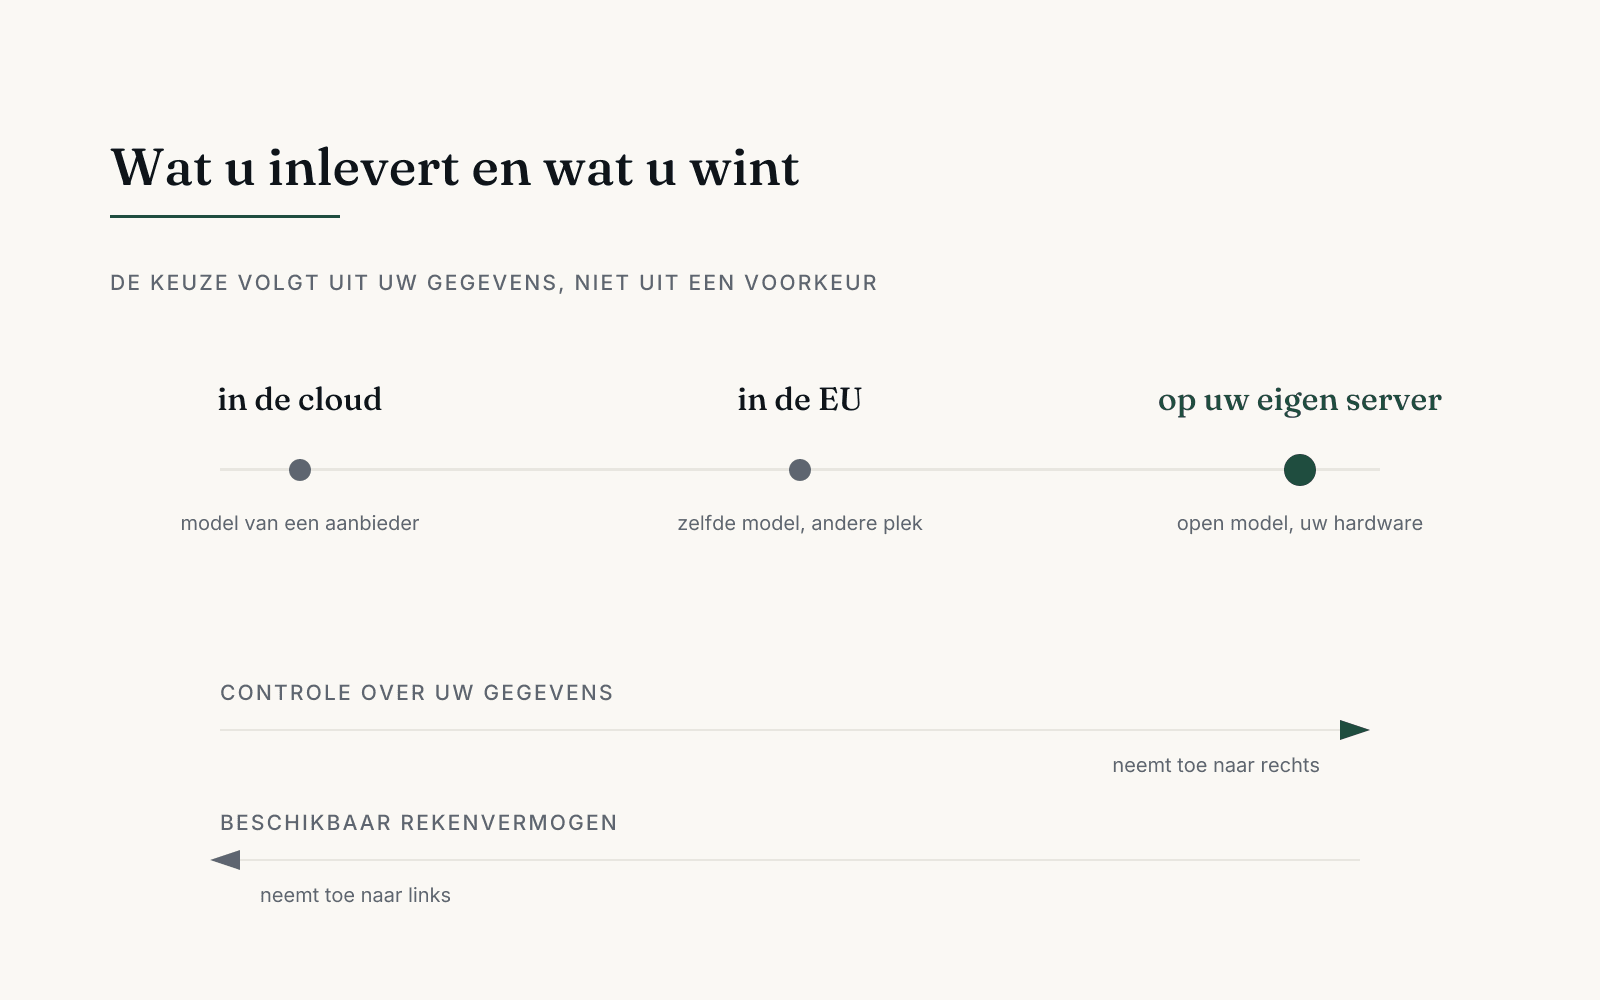
Er zijn in de praktijk drie plekken waar het rekenwerk kan gebeuren. Bij een aanbieder in de cloud, meestal buiten de EU. Bij een aanbieder die het binnen de EU draait. Of op hardware die van u is en in uw eigen pand of bij uw eigen hostingpartij staat. Die derde optie is de laatste jaren van theoretisch naar gewoon haalbaar gegaan, en dat is voor het MKB de belangrijkste ontwikkeling van de afgelopen tijd.
Wat op uw eigen server werkelijk betekent
Er bestaan taalmodellen waarvan de gewichten, dus het model zelf, te downloaden zijn. Die worden open modellen genoemd. U zet zo'n model op een machine met een geschikte grafische kaart, en vanaf dat moment gebeurt het rekenwerk daar. Er gaat geen document, geen vraag en geen antwoord naar buiten. Het systeem heeft er zelfs geen internetverbinding voor nodig.
Dat is fundamenteel iets anders dan een verwerkersovereenkomst met een cloudpartij, hoe goed die overeenkomst ook is. Bij een overeenkomst gaan uw gegevens wel degelijk het pand uit en spreekt u af wat ermee mag gebeuren. Bij een model op eigen hardware is er niets af te spreken, want er gaat niets weg. Voor sommige organisaties is dat verschil juridisch niet noodzakelijk maar wel doorslaggevend in het gesprek met hun eigen klanten.
Welk werk hier prima op draait
Verreweg het meeste bedrijfswerk. Documenten uitlezen en er vaste velden uit halen, teksten samenvatten, inkomende post sorteren op onderwerp en urgentie, een concept-antwoord opstellen, en vragen beantwoorden uit uw eigen kennisbank. Dat zijn taken waarbij het model vooral tekst moet begrijpen en herordenen, en daar zijn de open modellen inmiddels goed genoeg voor. In een kennisbank-opzet komt daar bij dat het model de relevante passages al meekrijgt, dus het hoeft de kennis niet zelf te bezitten.
Wat er ook goed op werkt, en dat wordt vaak vergeten: alles wat gevoelig is maar taalkundig eenvoudig. Een naam en een burgerservicenummer uit een formulier halen is geen zwaar redeneerwerk, maar het is wel precies het gegeven dat u niet naar buiten wilt sturen. Juist voor dat soort taken is lokaal draaien een goedkope oplossing voor een groot bezwaar.
Wat u inlevert
Op het zwaarste redeneerwerk zijn de grote cloudmodellen nog altijd sterker. Denk aan een ingewikkelde juridische afweging, een lange keten van stappen die het model zelf moet bedenken, of een taak waarbij het echt creatief moet zijn. Het gat is kleiner geworden dan het twee jaar geleden was, maar het is er nog, en ik benoem dat liever vooraf dan dat u het zelf ontdekt bij de eerste lastige zaak.
U levert ook tempo in. Cloudmodellen worden om de paar maanden vervangen door een betere versie, zonder dat u er iets voor hoeft te doen. Bij een eigen opstelling bepaalt u zelf wanneer u overstapt, wat rust geeft maar ook betekent dat u het bijhouden zelf moet organiseren. En u wordt beheerder van hardware: er staat een machine die stroom gebruikt, die stuk kan en die vervangen moet worden.
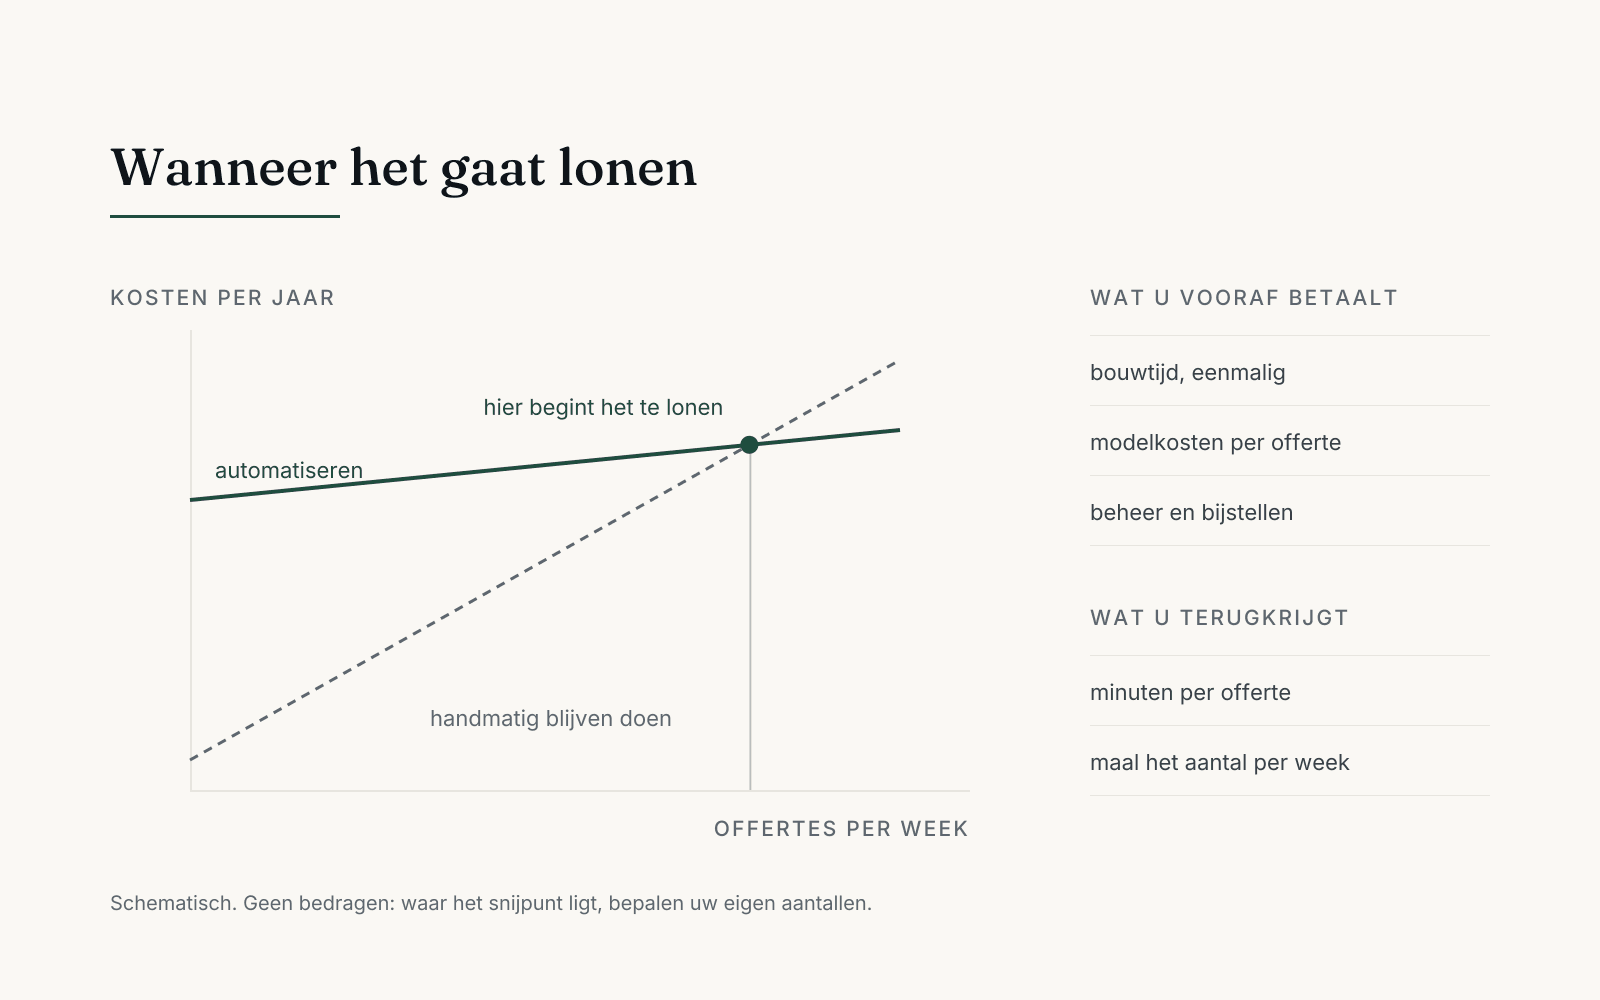
Tot slot verschuift de kostenstructuur. In de cloud betaalt u per gebruik en begint u bij vrijwel nul. Op eigen hardware betaalt u vooraf en daarna weinig. Dat is bij weinig gebruik ongunstig en bij veel gebruik juist gunstig, en het maakt uw kosten voorspelbaar. Welke van de twee beter uitkomt, is opnieuw een rekensom en geen principe.
Wat het oplevert, naast privacy
Het eerste is aantoonbaarheid. Als u zelf onder toezicht staat of voor opdrachtgevers werkt die dat zijn, kunt u aanwijzen welke gegevens waar staan, wie erbij kan en wat het systeem heeft gedaan. Dat is een heel ander gesprek dan verwijzen naar de voorwaarden van een leverancier aan de andere kant van de oceaan.
Het tweede is dat u niet afhankelijk bent van beslissingen van een ander. Een aanbieder kan een model uitfaseren, zijn prijzen aanpassen of zijn voorwaarden wijzigen. Draait het bij u, dan blijft het draaien zoals het draaide, ook over drie jaar. Voor een systeem dat in uw dagelijkse werk zit, is dat meer waard dan het op het eerste gezicht lijkt.
De hybride tussenweg, en waarom die vaak wint
In de praktijk kies ik zelden helemaal links of helemaal rechts op de lijn. De meest voorkomende opzet is hybride: wat gevoelig is, blijft lokaal, en voor de rest gebruiken we het sterkste model dat er is. Concreet betekent dat bijvoorbeeld dat een dossier lokaal wordt uitgelezen en geanonimiseerd, en dat alleen de geanonimiseerde vraagstelling naar een cloudmodel gaat als daar meer denkwerk voor nodig is.
Die opzet vraagt wel dat u vooraf de grens trekt: welke gegevens mogen het pand niet uit, en welke maakt het niet uit. Dat is geen technische vraag, dat is een vraag over uw bedrijf, en u kunt hem beter beantwoorden dan ik. Uit die grens volgt de rest vanzelf.
Hoe ik de keuze in de praktijk maak
Ik begin nooit bij de vraag welk model het beste is, maar bij de vraag welke gegevens er in het proces zitten. Daarna kijk ik hoe zwaar het denkwerk werkelijk is, en dat valt vaker mee dan mensen verwachten. Pas dan komt de plek waar het draait aan de orde, en die volgt uit de eerste twee antwoorden in plaats van uit mijn voorkeur. Wat er ook uitkomt, ik leg vast welke gegevens waarheen gaan en wat ermee gebeurt, zodat u dat aan een klant of een toezichthouder kunt laten zien.
En als lokaal draaien in uw situatie niet verantwoord haalbaar is, bijvoorbeeld omdat het denkwerk echt te zwaar is voor wat er redelijkerwijs bij u kan staan, dan hoort u dat van mij voordat er iets gebouwd wordt. Dat is geen verkooppraatje, dat is de goedkoopste manier om erachter te komen.
Bronnen
- Artikel 28 AVG (verwerker, verwerkersovereenkomst, subverwerkers en aansprakelijkheid) https://eur-lex.europa.eu/legal-content/NL/TXT/?uri=CELEX%3A32016R0679
- Artikel 32 AVG (beveiliging van de verwerking)
- Autoriteit Persoonsgegevens, doorgifte van persoonsgegevens naar landen buiten de EER https://www.autoriteitpersoonsgegevens.nl/
- Verordening (EU) 2024/1689, de Europese AI-verordening https://eur-lex.europa.eu/legal-content/NL/TXT/?uri=CELEX%3A32024R1689
Beeld: Eigen werk, Aether AI · Geen licentie van derden nodig